2026年10月4日 · @li
摘要
本研究建立了一个循环迭代的多保真度筛选框架,在 L0 层级比较了 166 种物理上兼容的裂变能装置构型。主要结论是:若把”本征安全”定义为可引入反应性低于 0.5 倍缓发中子份额 β,那么在本设计空间内,只有外源驱动的次临界系统能够通过。
研究对象是一个形态矩阵,由五个离散维度组合而成:中子来源、能谱、燃料形态、冷却剂、燃料循环,共 864 种组合。每种组合另带 7 个连续设计参数。评价采用四步法:
- 用兼容性剪枝和分层抽样构成筛选漏斗;
- 用硬门槛先划定可行域,再在可行域内做四目标帕累托优化,四个目标是安全、资源利用、废物嬗变、经济-成熟度;
- 用混合离散-连续的 NSGA-II 算法做多轮外层迭代,直到超体积收敛;
- 用蒙特卡罗扰动检验稳健性,用点堆动力学做瞬态验证。验证中发现的失效模式会被写回闸门集,进入下一轮迭代。
两轮完整迭代共做了约 15 万次 L0 评估。第一轮得到 732 个前沿点,分布在 22 个组合族;第二轮加入由瞬态验证学到的两道闸门后,收缩为 684 点、21 个组合族。灵敏度扫描显示,有两条结论在所有设定下都稳健:TRISO 球床氦冷堆在临界堆中稳健通过率最高,约 0.95;ADS 驱动的熔盐快谱次锕系焚烧方案的废物嬗变得分始终最高,约 1.9。另有两条结论高度依赖人为设定:聚变-裂变混合堆的竞争力,以及液态燃料临界堆是否出局。
认知地位声明:全部结果只在 L0 模型的意义上成立,即四因子公式、单群泄漏、集总热工。模型参数分为三类,各有标注:[D] 表示评价核数据的近似值,[C] 表示按参考堆型粗校准的工程参数,[H] 表示价值判断。本报告不构成任何工程设计、许可或安全分析的依据。
一、研究问题与评价框架
评价框架的核心判断是:安全不参与加权折算,它只决定可行域的边界;只有在可行域之内,才比较其余目标的优劣。
1.1 问题提法的校正
原始问题要求一种”不会超临界”的链式反应。在物理上,任何反应堆升功率时都必须短暂处于 k_eff > 1 的状态。真正需要排除的是瞬发超临界,即反应性 ρ ≥ β_eff:此时功率的倍增时间由瞬发中子代时间 Λ 决定,热堆约为 10⁻⁴ 秒,快堆约为 10⁻⁷ 秒,任何控制手段都来不及响应。因此,研究目标被重述为两条路线:
- 路线 A:临界堆,但在物理上保证瞬发超临界不可能发生;
- 路线 B:永久次临界的外源驱动堆。
1.2 三级安全保证
这一分级是本研究提出的分析框架,不是行业标准术语,但每一级都对应一条可计算的物理判据。
| 等级 | 物理判据 | 保证的来源 | 安全目标中的等级分数 |
|---|---|---|---|
| 第一级 | 一切可信物质状态下 k∞ < 1 | 物理定律,与几何构型无关 | 3 |
| 第二级 | 一切工况下 k_eff ≤ k_limit < 1,但 k∞ 可以大于 1 | 依靠中子泄漏,怕几何重排 | 2 |
| 第三级 | 可引入反应性总和 < β_eff,且所有反馈系数为负 | 工程限值加负反馈 | 1 |
1.3 评价模式
评价由三个相互嵌套的结构组成:
- 筛选漏斗:沿保真度逐级淘汰,从形态矩阵全组合,到兼容性剪枝,到抽样可行性检验,再到帕累托前沿,最后到代表点验证。
- 约束化多目标优化:先用硬门槛划定可行域,再在可行域内求四目标的帕累托前沿。安全只在可行域内部作为排序目标之一,从不与经济性相互折算。
- 闭环迭代:验证阶段发现的失效模式被写成新的硬门槛,或者被用来修正模型,然后重新进入优化。
| 层级 | 工具 | 单方案耗时 | 本研究中的实现 |
|---|---|---|---|
| L0 | 解析公式:四因子公式、单群泄漏、集总热工 | 约 0.7 毫秒 | 已实现,承担全部筛选 |
| L1 | 点堆动力学、一维热工 | 毫秒到秒 | 实现了简化版,只用于代表点验证 |
| L2 | 蒙特卡罗输运与燃耗计算 | 小时 | 未实现,列为后续工作 |
| L3 | 多物理场耦合 | 天 | 未实现 |
| L4 | 实验 | 年 | 超出本研究范围 |
二、理论基础
所用理论都是经典反应堆物理的标准内容,属于教科书层级的知识,本节只交代各公式在模型中的角色和简化假设。
2.1 中子增殖与四因子公式
无限介质增殖因子 k∞ 是排除泄漏后的增殖能力上限。热谱系统采用四因子公式:
各因子的含义如下:η 是每吸收一个中子在燃料中产生的新中子数;ε 是快裂变因子;p 是共振逃脱概率;f 是热中子利用系数。快谱系统没有慢化过程,直接写成:
其中 φ_par 是冷却剂、结构材料和裂变产物的寄生吸收份额。混合燃料的 η 按原子份额 a_i 和单群截面加权:
2.2 泄漏与有效增殖因子
采用单群扩散近似下的不泄漏概率:
其中 M² 是迁移面积,B² 是几何曲率,R̃ 和 H̃ 是加上反射层节省后的外推尺寸。热谱的迁移面积写成 M² = τ + L²,即费米年龄与热扩散面积之和。
2.3 缓发中子与反应性尺度
混合燃料的缓发中子份额按中子产额加权:
液态燃料中的缓发中子先驱核会随燃料流出堆芯,因此有效份额要打折扣,取 β_eff = 0.65 β。这一系数参考了 MSRE 实验堆的数据,属于 [C] 类参数。
2.4 点堆动力学
瞬态验证采用单组等效缓发中子的点堆方程,并叠加绝热的燃料温升反馈:
其中 λ 取 0.08 s⁻¹。由此可以推出瞬发跳跃近似:当阶跃引入的反应性为 ρ 时,功率会瞬间跃升到原来的 β/(β − ρ) 倍。第二轮迭代正是根据这个关系发现了 L0 闸门的漏洞。
2.5 次临界倍增
外源驱动系统中,每个源中子平均引发的裂变次数为:
由此可以写出散裂源驱动系统的能量增益:
其中 n_p 是每个质子产生的散裂中子数,取 27;E_f 是每次裂变释放的能量,取 200 MeV;E_p 是质子能量,取 1 GeV。
2.6 衰变热
采用 Way-Wigner 近似:停堆后 t 秒时的衰变热功率为 P_d(t)/P = 0.066 t^(-0.2)。这一近似在停堆后 10 秒到 100 天的范围内,与精确计算的偏差约在 30% 以内,属于 [D] 类参数。
三、设计空间编码
设计空间由 5 个离散维度和 7 个连续基因构成。离散维度共有 3 × 3 × 4 × 6 × 4 = 864 种组合,用 13 条兼容性规则剪枝后剩下 166 种。
第二轮分析中提出的七个维度,有两个没有进入编码:系统层级(群堆共生)和能量用途。前者在单堆评价中无法表达,后者不影响反应性和衰变热这两项安全判据,因此暂不建模。
| 维度 | 选项 |
|---|---|
| 中子来源 | 临界自持、加速器散裂源、D-T 聚变源 |
| 能谱 | 热谱、快谱、快-热分区 |
| 燃料形态 | 氧化物芯块、金属合金、TRISO 球床、液态熔盐燃料 |
| 冷却剂 | 轻水、液态钠、铅或铅铋、氦气、氟盐 FLiBe、氯盐 |
| 燃料循环 | 低浓铀一次通过、铀-钚闭式循环、钍-铀233 循环、钚加次锕系焚烧 |
3.1 连续基因
每个连续基因 g_j 都在 [0, 1] 区间内取值,再按所属构型映射到对应的物理量程。
| 基因 | 物理量 | 映射方式与量程 |
|---|---|---|
| g0 | 功率密度 q | 线性映射,量程随冷却剂与燃料组合而定,例如 TRISO 氦冷为 2 到 8 MW/m³,钠冷为 100 到 400 MW/m³ |
| g1 | 慢化比 x(慢化剂分子数与重金属原子数之比) | 对数映射:水为 1 到 6,石墨为 100 到 1500 |
| g2 | 卸料燃耗 B | 线性映射:10 GWd/t 到燃料形态允许的上限(80 到 200 GWd/t) |
| g3 | 目标 k 值 | 线性映射:0.85 到 0.985,只对外源驱动系统生效 |
| g4 | 热功率 P | 对数映射:10 到 3000 MW |
| g5 | 聚变增益 Q | 对数映射:1 到 10,只对聚变驱动系统生效 |
| g6 | 次锕系份额 | 线性映射:0.05 到 0.60,只对焚烧循环生效 |
燃料富集度(或钚份额)不作为设计变量,而是由临界条件反解出来,详见第 4.3 节。
3.2 兼容性剪枝规则
其中 11 条排除的是物理上或工程上不成立的组合,第 10 条和第 12 条只是范围界定。
- 液态燃料必须以熔盐为载体。
- 氯盐只作液态燃料的载体。
- 氯盐只用于快谱,因为它慢化能力差,Cl-35 的寄生吸收又大。
- 轻水只能与热谱氧化物燃料组合。
- 液态金属不能慢化中子,不构成热谱。
- 液态金属不与 TRISO 燃料或熔盐燃料组合。
- 金属燃料只与液态金属冷却剂组合。
- TRISO 燃料只用于氦气或氟盐冷却的热谱堆。
- 氧化物芯块与氟盐冷却缺乏成熟组合。
- 不考虑氦冷分区谱(范围界定)。
- 次锕系焚烧不用热谱,因为热谱中次锕系以俘获为主,裂变份额很低。
- 不考虑散裂靶与轻水堆芯的耦合(范围界定)。
- 聚变驱动不与钠或氯盐组合:钠在强磁场下有磁流体动力学问题,氯盐不适合氚增殖包层。
四、L0 计算方法详解
对每个设计点,L0 评估依次完成六步:构造燃料成分、计算中子学参数、反解富集度、计算反应性与反馈、计算被动排热与能量平衡、判定闸门并计算目标函数。单点平均耗时约 0.7 毫秒。
4.1 核数据与燃料成分
核数据采用单群谱平均截面,热谱为麦克斯韦平均值,快谱为典型快堆谱的平均值,精度约为 ±10% 到 30%,属于 [D] 类参数。
| 核素 | 热谱 σf / σc(b) | 快谱 σf / σc(b) | 快谱 ν | β |
|---|---|---|---|---|
| U-235 | 506 / 86 | 1.90 / 0.50 | 2.45 | 0.0065 |
| U-233 | 449 / 40 | 2.80 / 0.30 | 2.55 | 0.0027 |
| Pu-239 | 696 / 259 | 1.80 / 0.45 | 2.95 | 0.0021 |
| Pu-241 | 932 / 320 | 2.50 / 0.40 | 2.98 | 0.0049 |
| U-238 | 0 / 2.37 | 0.045 / 0.28 | 2.80 | 0.0148 |
| Th-232 | 0 / 6.5 | 0.010 / 0.33 | 2.40 | 0.0203 |
| Pu-240 | 0 / 257 | 0.40 / 0.50 | 3.00 | 0.0029 |
| Np-237 | 0.02 / 155 | 0.35 / 1.40 | 2.90 | 0.0011 |
| Am-241 | 2.7 / 532 | 0.30 / 1.50 | 3.30 | 0.0013 |
四种燃料循环的重金属成分都写成富集度 e(易裂变份额或钚份额)的函数:
- 低浓铀:U-235 占 e,U-238 占 1 − e;
- 铀-钚循环:堆级钚占 e,其同位素构成为 Pu-239、Pu-240、Pu-241、Pu-242 各占 60%、25%、10%、5%;其余为 U-238;
- 钍-铀循环:U-233 占 e,其余为 Th-232;
- 次锕系焚烧:钚占 e,次锕系(Np-237 与 Am-241 各半)占设计变量规定的份额 m,其余为 U-238,并要求 e + m ≤ 1。
4.2 中子学模型
热谱。 共振逃脱概率采用均匀化的指数近似,以有效共振积分 I_i 表示非均匀栅格的自屏效应:
有效共振积分的取值为:U-238 取 30 b,Th-232 取 20 b,Pu-240 取 1500 b。每分子的 ξσs 取值为:水 40 b,石墨 0.74 b。热谱的寄生吸收份额包括三部分:冷却剂与结构材料,约 0.5% 到 6%;附加结构,1%;裂变产物,固体燃料 3%,液态燃料因在线除氙取 1.5%。
快谱。 直接采用 2.1 节的 η 公式,寄生吸收份额加上结构材料的 3%。
转换比。 热谱的转换比把共振俘获中属于可转换核的部分和热俘获合在一起计算;快谱则直接用可转换核俘获与易裂变核吸收之比:
这里的可转换核包括 U-238、Th-232 和 Pu-240。
快-热分区谱。 k∞、转换比、迁移面积和 β 都取快区与热区的算术平均。这是全模型中最粗糙的近似,第十节专门讨论它的影响。
几何与泄漏。 堆芯取高径比为 1 的圆柱:体积 V = P/q,半径 R = (V/2π)^(1/3)。反射层节省取值为:水 10 cm,石墨 50 cm,快谱 15 cm,分区谱 30 cm。快谱迁移面积取值为:钠 300 cm²,铅 350 cm²,氦 600 cm²,熔盐 300 cm²。
4.3 富集度反解
富集度 e 由下式在燃料循环允许的区间内用二分法求解,迭代 40 次:
由于燃耗反应性摆幅依赖转换比,而转换比又依赖富集度,所以在外层做 4 次不动点迭代。如果把富集度取到上限仍达不到要求的 k 值,就触发”富集度不足”闸门。低浓铀方案的进料富集度上限为 20%,即 HALEU 限值。
4.4 反应性与反馈
燃耗反应性摆幅。 在线换料的燃料形态(TRISO 球床、液态燃料)取固定值 300 pcm。批量换料按三批次计算,每循环燃耗 B_c = B/3:
系数取值为:α_spec 热谱 0.012、快谱 0.003、分区谱 0.007;α_FP 热谱 0.0015、快谱 0.0003、分区谱 0.0009,单位都是每 GWd/t。
空泡反应性。 按构型分四种情况处理:
- 液态燃料:冷却剂沸腾或泄漏时燃料随之排出堆芯,取 −0.015。
- 轻水:由模型直接计算,令慢化比 x 降为原来的十分之一,比较前后的 k_eff。
- 其余热谱:氦冷取 0,氟盐冷却取 +0.003。
- 快谱:写成谱硬化项减去泄漏项:
其中 h₀ 对铀-钚和次锕系燃料取 1,其他燃料取 0.5。系数 (a_c, b_c) 取值为:钠 (0.030, 0.15),铅 (0.015, 0.10),氦 (0.004, 0.02)。分区谱的结果再乘以 0.5。
反馈系数(单位 pcm/K):
- 多普勒系数:α_D = −k_D × a_fert,其中 a_fert 是 U-238 与 Th-232 的原子份额之和。k_D 取值为:热谱 3.5(TRISO 取 4.0),钠冷快谱 0.9,铅冷快谱 1.1,氦冷快谱 0.8,熔盐快谱 1.0,分区谱 2.0。
- 冷却剂温度系数:α_c = ρ_void × 10⁵ × 冷却剂体膨胀系数。
- 液态燃料膨胀系数:热谱 −3,快谱 −5。
- 固体燃料膨胀系数:第二轮迭代新增,金属燃料 −0.8,氧化物燃料 −0.3。
瞬发系数 α_prompt = α_D + α_exp,等温系数 α_iso = α_D + α_c + α_exp。
过冷引入的反应性:ρ_oc = max(0, −α_iso) × 20 K。
4.5 闸门
| 闸门 | 适用对象 | 判据 |
|---|---|---|
| 富集度不足 | 全部 | 富集度在上限内能达到所需 k 值 |
| HALEU 上限 | 低浓铀循环 | 进料富集度 ≤ 20% |
| 瞬发临界裕度 | 临界堆 | ρ_ins = Δρ_swing + max(0, ρ_void) + ρ_oc < β_eff |
| 次临界上限 | 外源驱动堆 | k_max = k_target + Δρ_swing/2 + max(0, ρ_void) + ρ_oc + 2σ_k ≤ 0.985,其中 σ_k = 0.004 + 0.03 a_MA |
| 反馈为负 | 全部 | α_prompt < −0.05 且 α_iso < −0.05 |
| 被动排热 | 全部 | 被动排热裕度 ≥ 1(见 4.6 节) |
| 净效率 | 全部 | η_net ≥ 0.10 |
| 束流功率 | 散裂源驱动 | 束流功率 ≤ 40 MW |
| 聚变功率下限 | 聚变驱动 | 聚变功率 ≥ 50 MW,属于 [H] 类参数 |
| 反馈补偿温升 | 临界堆,第二轮新增 | ρ_ins / |α_prompt| ≤ 燃料允许温升:氧化物 900 K,金属 300 K,TRISO 700 K,熔盐 400 K |
| 次临界功率跃升 | 外源驱动堆,第二轮新增 | ρ₀/ρ₁ ≤ 2,其中 ρ₀、ρ₁ 分别为名义状态和最坏状态的反应性 |
违约量按闸门分别归一化后加总,作为约束支配的依据。第一级安全等级的判定方法是:对热谱和分区谱,在慢化比的 5 个点上扫描,取 k∞ 的最大值;再计入燃耗摆幅的一半和正的空泡反应性,若结果仍小于 1,即判为第一级。
4.6 被动排热的集总能量平衡
假设失去全部主动冷却,衰变热只能靠容器外表面的被动排热导出。容器尺寸按堆芯尺寸放大:半径 R_v = r_v × R + 0.3 m,高度 H_v = h_v × H + 1 m。被动排热能力为:
液态燃料乘以 2,代表泄放罐提供的额外排热能力。单位面积排热能力 q_cap 取值为:液态金属和熔盐 15 kW/m²,氦气 5 kW/m²,水 10 kW/m²(容器浸没在水池中)。
衰变热功率与排热能力相等的时刻为:
在此之前,衰变热超出排热能力的部分必须由热容吸收:
可用的热缓冲包括显热和水的潜热:
被动排热裕度定义为 E_buf / E_exc,上限截断为 100。这个模型揭示了一个关键的标度关系:t* 与 (P/Q_cap)⁵ 成正比,所以被动排热能力从根本上限制了单堆功率,同时青睐低功率密度、大容器的设计。
4.7 能量平衡
- 临界堆:η_net = η_th × (1 − 0.04),其中 0.04 是厂用电份额。
- 散裂源驱动:按寿期内最低的 k 值 k_min 计算能量增益 G,束流功率 P_beam = P/G,加速器电效率取 0.30。
- 聚变驱动:包层能量倍增系数 M = (14.1 + 4.8 × TBR + N_f × 200)/14.1,其中 N_f 计入 (n,2n) 倍增因子 1.2,4.8 MeV 是 Li-6(n,t) 反应释放的能量;聚变功率 P_fus = P/(0.2 + 0.8M);等离子体加热功率 P_fus/Q,加热效率取 0.40。为保证氚自持(TBR = 1.1),在每个源中子引发的中子总数中预留 1.1/0.9 个用于锂吸收,并把这部分计入富集度反解时的寄生吸收,使中子账前后自洽。
4.8 目标函数
四个目标都是越大越好。
- 安全:等级分数加上 0.99 × min(m_r, m_p)。其中 m_r 是归一化的反应性裕度;m_p = log₁₀(被动排热裕度)/2,截断在 [0, 1] 区间内。取两者中较小的一项,体现”短板决定”的原则。
- 资源利用:log₁₀(U × 资源丰度系数),钍的丰度系数取 3。一次通过循环的资源利用率 U = FIMA / 进料比;闭式循环中,转换比 CR ≥ 1 时 U = 0.6(受后处理损失限制),否则 U = min(0.6, 0.0071/(1 − CR) + 0.2 FIMA)。
- 废物嬗变:各燃料循环和能谱有一个基准值,再加上 20 × 次锕系份额 × 次锕系的裂变份额 σf/σa。这是启发式指标,属于 [H] 类。
- 经济-成熟度:η_net × (系统 TRL/9) × (P/1000)^0.1。系统 TRL 取各组成部分 TRL 的最小值;散裂源的 TRL 随束流功率下降,聚变源在 Q > 5 时 TRL 取 2。
五、优化与筛选方法
筛选流程分六个阶段,前三个阶段负责搜索,后三个阶段负责验证和回馈。整个闭环中,从验证回到闸门集的那条回路是本方法与一次性优化的根本区别。
5.1 阶段一和阶段二:枚举与分层抽样漏斗
先枚举全部 864 种离散组合,用兼容性规则剪枝。对剩下的 166 种组合,各做 240 次连续参数抽样,用分层方法保证每个基因在 240 个等分区间中各被抽到一次,然后统计每种组合的可行抽样占比,以及造成失效的主要闸门。主要闸门指违约量最大的那一道。这一步共做约 4 万次评估。
5.2 阶段三:约束支配 NSGA-II
算法采用 Deb 等人 2002 年提出的 NSGA-II,并加入 Deb 的约束支配规则:
- 可行解优于不可行解;
- 两个解都不可行时,违约量小的优;
- 两个解都可行时,按帕累托支配比较。
离散维度和连续基因分别采用不同的变异算子:
- 离散维度:均匀交叉,再以 0.15 的概率随机重置。若产生不兼容的组合,以 0.8 的概率退回到某个随机的兼容组合,同时保留连续基因不变。
- 连续基因:模拟二进制交叉(分布指数 15)加多项式变异(分布指数 20,变异概率 1/7)。
选择采用基于非支配等级和拥挤距离的二元锦标赛。种群规模 160,每轮 60 代,每轮约 9760 次评估。
5.3 外层迭代与收敛判据
每一轮结束后,把本轮前沿并入全局档案,再从档案中筛出非支配集。下一轮的初始种群一半来自全局前沿,一半是从”存在可行点的组合”中随机抽取的移民,用来注入多样性。
收敛用超体积指标判断。四个目标先按固定区间归一化:安全 [1, 4],资源利用 [−3, 0.3],废物嬗变 [−1.5, 3],经济-成熟度 [0, 0.5];参照点取原点,用 2 万个样本的蒙特卡罗方法估计超体积。如果连续两轮的相对改进都小于 0.5%,或者达到 8 轮上限,即判定收敛。
5.4 阶段四:稳健性分析
验证阶段的计算更昂贵,所以不对全部前沿点做,而是对每个组合族沿目标得分总和等距抽取至多 10 个代表点。对每个代表点做 200 次扰动,扰动服从正态分布,各参数的乘子及标准差如下:
| 被扰动的参数 | 乘子的标准差 |
|---|---|
| β | 5% |
| 次锕系截面 | 15% |
| 易裂变核截面 | 2% |
| 空泡反应性 | 30% |
| 多普勒系数 | 20% |
| 被动排热能力 | 20% |
统计每个代表点在扰动下仍然通过全部闸门的比例,即稳健通过率,同时记录失效的主要原因。
5.5 阶段五:瞬态验证
对代表点求解 2.4 节的点堆方程,计算时长 20 秒,采用适用于刚性方程的 Radau 方法(相对误差 10⁻⁶),以兼顾快谱 10⁻⁷ 秒量级的瞬发中子代时间。
- 临界堆:在 t = 0 时阶跃引入全部可引入反应性 ρ_ins。这是一个最坏情形假设:所有反应性来源同时、瞬时地叠加。
- 外源驱动堆:在保持外源不变的条件下,阶跃引入使 k 从名义值升到 k_max 的反应性,这里的 k_max 不含 2σ 不确定度项。另外计算外源跳闸后的功率瞬发落差,近似为 β/(β − ρ₀)。
燃料温升采用绝热假设:排热维持在名义水平,多出来的功率全部用于加热燃料。这一假设偏保守。
5.6 阶段六:回馈
如果验证发现了闸门没有覆盖的失效模式,就做两种处理之一:
- 新增闸门:把这种失效模式写成新的硬门槛;
- 修正模型:如果失效是由模型缺项造成的,就补上缺项。
然后从阶段一重新开始。第二轮迭代就是这样产生的,过程见第七节。
六、模型校准与参考堆型检验
校准的目标不是复现参考堆型的精确参数,而是让模型对参考堆型给出与工程认识一致的定性判断:该通过的通过,该失败的失败。校准后,六个参考堆型中有四个与工程认识完全吻合;另外两个存在偏差,偏差都来自判据偏严,而不是判据偏松。
校准分两步。第一步,用初值运行模型。结果发现被动排热模型系统性偏严:在初值 q_cap = 6 kW/m² 下,连 PRISM 和 NuScale 类小堆这些公认能够被动排热的设计,裕度也只有 0.06 和 0.04。第二步,依据物理上限修正参数:
- 液态金属与熔盐:容器在 550 到 650°C 运行时,辐射与自然对流的热流密度可达 15 到 19 kW/m²,因此取 15 kW/m²。
- 轻水:一体化压水堆的容器浸没在大水池中,取 10 kW/m²;容器高度取堆芯高度的 8 倍,代表一体化设计中细长的压力容器。
- 轻水的冷却剂温度系数:初值算出约 −90 pcm/K,明显偏大,把体膨胀系数从 1×10⁻³/K 修正为 3×10⁻⁴/K 后,降到约 −27 pcm/K,进入合理范围。
| 参考堆型 | 模型输入 | 被动排热裕度 | 关键反应性结果 | 判断 | 是否与工程认识一致 |
|---|---|---|---|---|---|
| 大型压水堆 | 3000 MWt,100 MW/m³ | 0.02 | 可引入反应性约 11000 pcm,远大于 β | 两项都不通过 | 一致:依赖主动系统和控制棒 |
| NuScale 类一体化小堆 | 160 MWt,70 MW/m³ | 8.84 | 批量换料的摆幅远大于 β | 排热通过,反应性不通过 | 一致:被动排热成立,反应性依赖控制 |
| HTR-PM 类球床堆 | 250 MWt,3.2 MW/m³ | 12.7 | 可引入反应性 418 pcm,小于 β 的 650 pcm | 全部通过 | 一致 |
| PRISM 类池式钠冷堆 | 471 MWt,金属燃料 | 2.36 | 批量摆幅 3887 pcm | 排热通过,反应性不通过 | 排热一致;反应性偏严 |
| 大型钠冷堆 | 3000 MWt,氧化物燃料 | 0.08 | 空泡反应性 +861 pcm | 两项都不通过 | 一致:正空泡效应、排热不足 |
| 钍基熔盐热堆 | 500 MWt | 100 | β_eff 仅 176 pcm | 排热通过,反应性不通过 | 存疑:静态判据偏保守 |
这张表揭示了一个评价立场问题:第三级闸门的判据,是”在不依赖任何控制系统的情况下也不会瞬发临界”。依照这个判据,所有批量换料的反应堆都会失败,包括运行良好的压水堆。这不意味着这些反应堆不安全,而是说明本研究选定的评价标准是”本征安全”,比现行的许可标准更严格。
七、计算过程与结果
两轮迭代共进行约 15 万次 L0 评估。第二轮加入两道学习闸门后,前沿从 732 点收缩到 684 点,组合族从 22 个减到 21 个,淘汰的主要是金属燃料临界快堆。单轮全量计算在单核上约需 3 到 4 分钟。
7.1 第一轮:漏斗与失效分布
漏斗逐级收缩的情况是:全部 864 种组合,剪枝后剩 166 种,其中 101 种存在至少一个可行参数点,最终 22 个组合族进入帕累托前沿。
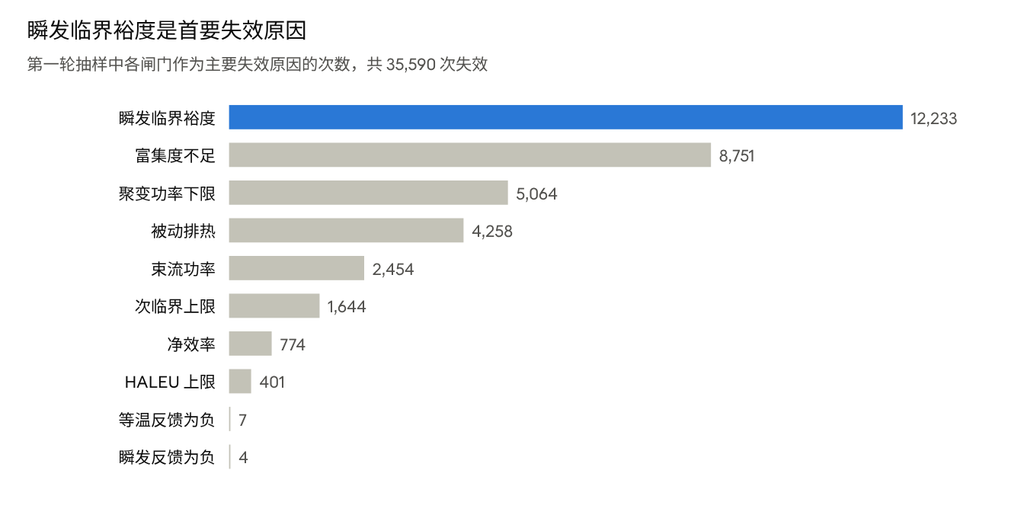
在约 4 万次抽样中,作为主要失效原因出现次数最多的三道闸门依次是:瞬发临界裕度、富集度不足、聚变功率下限。分布见下图。瞬发临界裕度失效约 1.2 万次,居于首位,定量证实了 β 约束是整个设计空间的主导约束。
[embed: node/0620daaa-fd06]
export default () => (
  <claude.Visualize
    data-claude-component="gate-failures-r1"
    sources={{
      rows: {
        kind: 'data',
        data: [
          { gate: '瞬发临界裕度', slug: 'prompt',   n: 12233 },
          { gate: '富集度不足',   slug: 'enrich',   n: 8751 },
          { gate: '聚变功率下限', slug: 'pfus',     n: 5064 },
          { gate: '被动排热',     slug: 'passive',  n: 4258 },
          { gate: '束流功率',     slug: 'beam',     n: 2454 },
          { gate: '次临界上限',   slug: 'ksub',     n: 1644 },
          { gate: '净效率',       slug: 'eta',      n: 774 },
          { gate: 'HALEU 上限',   slug: 'haleu',    n: 401 },
          { gate: '等温反馈为负', slug: 'iso',      n: 7 },
          { gate: '瞬发反馈为负', slug: 'promptfb', n: 4 },
        ],
      },
    }}
  >
    {({ rows, datum }) => {
      const peak = Math.max(...rows.map(r => r.n));
      const total = rows.reduce((s, r) => s + r.n, 0);
      const x0 = 170, w = 500, y0 = 78, rowH = 28;
      const bw = v => (v / peak) * w;

      return (
        <svg viewBox="0 0 760 380" role="img" aria-label="瞬发临界裕度是首要失效原因" fontSize="12">
          <text data-claude-text-id="title" x="20" y="28" fontSize="16" fill="var(--cds-text-primary)">
            瞬发临界裕度是首要失效原因
          </text>
          <text x="20" y="52" fill="var(--cds-text-secondary)">
            {`第一轮抽样中各闸门作为主要失效原因的次数,共 ${total.toLocaleString('en-US')} 次失效`}
          </text>

          <g data-claude-anchor="bars">
            {rows.map((r, i) => (
              <g key={r.slug} data-claude-anchor={`gate-${r.slug}`}>
                <text x={x0 - 10} y={y0 + i * rowH + 14} textAnchor="end" fill="var(--cds-text-primary)">
                  {r.gate}
                </text>
                <rect
                  x={x0}
                  y={y0 + i * rowH}
                  width={Math.max(bw(r.n), 1)}
                  height="18"
                  fill={i === 0 ? 'var(--cds-chart-categorical-1)' : 'var(--cds-chart-muted)'}
                  {...datum(r, 'n')}
                >
                  <title>{`${r.gate}:${r.n.toLocaleString('en-US')} 次`}</title>
                </rect>
                <text
                  x={x0 + Math.max(bw(r.n), 1) + 6}
                  y={y0 + i * rowH + 14}
                  fill="var(--cds-text-secondary)"
                  {...datum(r, 'n')}
                >
                  {r.n.toLocaleString('en-US')}
                </text>
              </g>
            ))}
          </g>
        </svg>
      );
    }}
  </claude.Visualize>
);
</claude.Visualize>
);
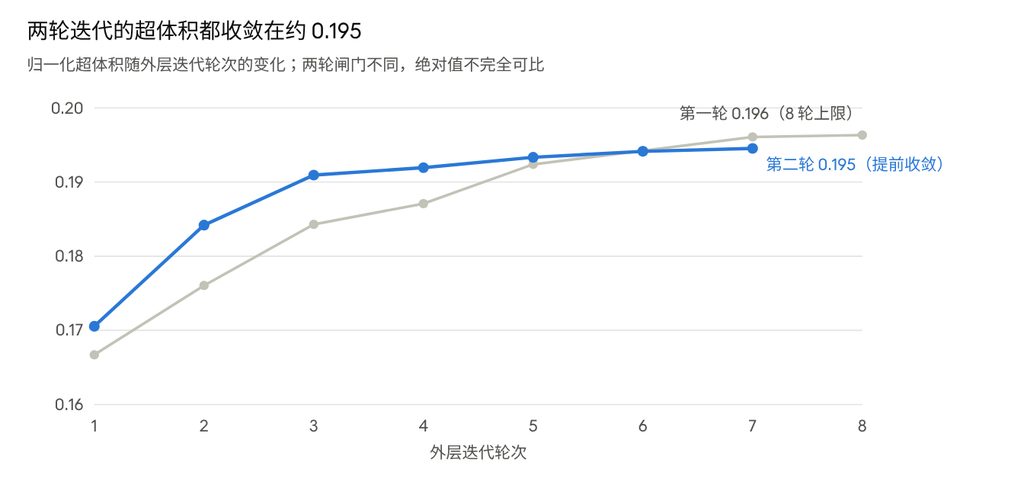
外层迭代第一轮进行了全部 8 轮,超体积单调上升并趋于平缓;第二轮在第 7 轮提前达到收敛判据。两轮的超体积轨迹见下图。
[embed: node/953e16c2-3cab]
7.2 第一轮的前沿结构
前沿呈三层结构,层与层之间的取舍发生在安全与成熟度之间:
- 临界堆层:安全得分 1.0 到 1.4,经济-成熟度最高可达 0.36 到 0.38,以 TRISO 球床氦冷堆为代表。
- ADS 层:安全得分 2.0 到 3.4,经济-成熟度 0.05 到 0.20。
- 聚变驱动层:安全得分 2.4 到 4.0,经济-成熟度 0.09 到 0.16。
7.3 瞬态验证暴露的漏洞
第一轮临界堆代表点的验证结果按组合族分组如下:
| 组合族(临界堆) | 最大峰值功率比 | 补偿温升范围(K) |
|---|---|---|
| TRISO 球床,氦冷,低浓铀 | 3.2 | 79 到 108 |
| 氧化物燃料,铅冷,低浓铀 | 3.4 | 668 到 740 |
| 金属燃料,钠冷,铀-钚 | 11.3 | 507 到 622 |
| 氧化物燃料,钠冷,低浓铀 | 31.2 | 897 到 1226 |
| 金属燃料,钠冷,低浓铀 | 16.3 | 940 到 1186 |
所有外源驱动方案的瞬态峰值功率比都不超过 2.2,其中液态燃料方案的燃料温升不超过 11 K。
诊断结论是:“可引入反应性小于 β”这一闸门本身没有错,但它不充分。对于多普勒反馈很弱的快谱燃料(|α_prompt| 小于 1 pcm/K),即使可引入反应性没有超过 β,也需要燃料升温几百到上千度才能被反馈抵消。
7.4 第二轮:学习闸门与模型细化
根据第一轮的诊断,第二轮做了两处修改:
- 新增两道闸门,即 4.5 节表中的“反馈补偿温升”和“次临界功率跃升”。
- 补入快谱固体燃料的膨胀反馈:金属燃料 −0.8 pcm/K,氧化物燃料 −0.3 pcm/K,分区谱减半。这一项在 L0 原模型中被遗漏了,而它正是 EBR-II 本征安全行为的主要来源。
| 变化 | 组合族 |
|---|---|
| 淘汰 | 临界金属燃料钠冷快堆(低浓铀、铀-钚两种);临界金属燃料铅冷低浓铀快堆;聚变驱动 TRISO 氟盐低浓铀堆 |
| 新增 | 聚变驱动分区谱铅冷钓循环堆(金属、氧化物两种燃料);ADS 金属燃料铅冷次锕系焚烧堆 |
第二轮前沿的主要组合族如下,按前沿点数排序:
| 组合族 | 前沿点数 | 最佳安全得分 | 最佳废物嬗变得分 | 最佳经济-成熟度 | 稳健通过率 |
|---|---|---|---|---|---|
| 临界,热谱,TRISO 球床,氦冷,低浓铀 | 173 | 1.42 | −1.0 | 0.36 | 0.95 |
| ADS,快谱,熔盐燃料,氟盐,次锕系焚烧 | 95 | 2.99 | 1.89 | 0.09 | 0.84 |
| 聚变,分区谱,氧化物,铅冷,次锕系焚烧 | 65 | 3.91 | 1.31 | 0.14 | 0.69 |
| 聚变,快谱,氧化物,铅冷,次锕系焚烧 | 63 | 3.72 | 1.54 | 0.15 | 0.94 |
| 聚变,分区谱,熔盐燃料,氟盐,次锕系焚烧 | 53 | 3.59 | 1.35 | 0.15 | 0.74 |
| 聚变,快谱,金属,铅冷,次锕系焚烧 | 52 | 3.65 | 1.71 | 0.15 | 0.86 |
| ADS,热谱,TRISO 球床,氦冷,低浓铀 | 41 | 2.59 | −1.0 | 0.20 | 0.99 |
| 临界,快谱,氧化物,钠冷,低浓铀 | 28 | 1.26 | −0.5 | 0.33 | 0.69 |
| 临界,快谱,氧化物,铅冷,低浓铀 | 22 | 1.36 | −0.5 | 0.24 | 0.96 |
| ADS,热谱,TRISO 球床,氦冷,钓循环 | 10 | 2.53 | 0.3 | 0.19 | 1.00 |
第二轮的验证又暴露出一个新漏洞:存活的钠冷氧化物低浓铀方案,可引入反应性在 β 的 0.74 到 0.95 倍之间,补偿温升没有超限,峰值功率却仍可达额定值的 47 倍。原因是可引入反应性越接近 β,瞬发跳跃 β/(β − ρ) 放大得越剧烈。这一发现直接引出了第八节的 β 系数扫描。
八、灵敏度分析
在第二轮的闸门体系下,对两个参数各自单独变动做了扫描:β 闸门系数和聚变功率下限。两者都呈开关式的行为:β 系数降到 0.5 时所有临界堆出局;聚变功率下限升到 150 MW 时所有聚变方案出局。
8.1 扫描设计
| 设定 | 变动的参数 | 搜索预算 | 存在可行点的组合 | 前沿组合族 |
|---|---|---|---|---|
| 第二轮基准 | β 系数 1.0,聚变下限 50 MW | 全量 | 99 | 21 |
| 聚变下限 150 MW | 聚变下限 | 全量 | 72 | 9 |
| 聚变下限 10 MW | 聚变下限 | 快速 | 94 | 16 |
| β 系数 0.8 | β 系数 | 快速 | 60 | 9 |
| β 系数 0.5 | β 系数 | 快速 | 56 | 7 |
快速模式的参数是:每种组合抽样 60 次,种群 100,每轮 25 代,共 3 轮。全量模式是:抽样 240 次,种群 160,每轮 60 代,最多 8 轮。
[embed: node/2fbde970-84d0]
8.2 β 闸门系数
- 系数 1.0:五个临界堆组合族存活。
- 系数 0.8:只剩 TRISO 球床氦冷堆和钠冷氧化物铀钚堆。
- 系数 0.5:所有临界堆全部出局,包括 TRISO 球床堆。
球床堆在 0.5 处出局的原因可以直接算出:它的可引入反应性约为 380 pcm,由两部分组成——在线换料保留的 300 pcm,加上 20 K 过冷带来的约 80 pcm(等温系数约 −4 pcm/K)。这超过了 β 的一半,约 325 pcm。
推论:如果把“本征安全”定义为可引入反应性不超过 0.5 美元(即半个 β),那么在本设计空间内,只有外源驱动的次临界系统能够满足要求。这为次临界路线的必要性给出了定量的边界。
8.3 聚变功率下限
- 下限 10 MW:聚变方案容易进入前沿,以熔盐包层方案为主。
- 下限 50 MW:聚变方案占前沿点的约 44%,但只存在于一个狭窄的区域:热功率 1000 到 3000 MW,k 值在 0.85 到 0.91 之间,功率密度很低。
- 下限 150 MW(全量计算):聚变方案在前沿上完全消失。
机理可以用两个关系式说明。热功率与聚变功率之比为:
在 k = 0.9 时,N_f 约为 4,M 约为 60。于是聚变功率不低于 150 MW,就意味着热功率不低于约 7000 MW,超出了热功率的搜索上限 3000 MW。即使把 k 降到搜索下限 0.85,M 仍约为 35,热功率仍需约 4200 MW。而热功率越大,越难满足被动排热闸门,因为 t* 与 (P/Q_cap)⁵ 成正比。
推论:聚变-裂变混合堆在本框架中的地位,几乎完全取决于一个属于 [H] 类的等离子体规模参数。在这个参数被物理模型取代之前,不应对聚变方案的排序下结论。
8.4 方法学教训:搜索深度的偏差
同样是聚变下限 50 MW 的基准设定,快速模式一个聚变前沿点都没有找到,而全量计算找到了 400 多个。所以,在三个快速模式的扫描中,聚变方案的占比很可能被低估了。可行域越狭窄,低预算搜索越容易系统性地漏掉它。改进办法是:在筛选漏斗的第二阶段,按可行域的宽窄自适应地分配抽样预算,而不是对所有组合均匀分配。
九、综合评价与结论分级
结论按其对人为设定的依赖程度分为三级:稳健结论在所有扫描设定下都成立;条件性结论只在特定设定下成立;模型产物则可能源于模型缺项,而不是物理事实。
| 结论 | 分级 | 依据 | 关键依赖 |
|---|---|---|---|
| 次锕系焚烧由 ADS 熔盐快谱方案承担,废物嬗变得分始终最高(约 1.9) | 稳健 | 所有设定下都成立;稳健通过率 0.84 | 次锕系截面精度约 ±15% |
| TRISO 球床氦冷堆是临界堆中最稳健的方案 | 稳健 | 稳健通过率 0.95;β 系数 0.8 时仍存活;补偿温升不超过 116 K | 在线换料保留的 300 pcm |
| 前沿呈三层结构,层间取舍发生在安全与成熟度之间 | 稳健 | 两轮迭代、所有扫描都呈现 | 成熟度评分属于 [H] 类 |
| 若可引入反应性须不超过 0.5 β,则只有次临界系统可行 | 条件性 | β 系数扫描 | 过冷温降取 20 K、静态阶跃判据 |
| 被动排热从根本上限制了单堆热功率 | 稳健(定性) | t* 与 (P/Q_cap)⁵ 成正比的标度关系;参考堆型校准 | q_cap 的绝对值属于 [C] 类 |
| 聚变-裂变混合堆占据安全维度的高端 | 条件性 | 只在聚变功率下限 ≤ 50 MW 时成立 | 聚变功率下限属于 [H] 类 |
| 金属燃料临界快堆不满足补偿温升判据 | 可能是模型产物 | 只用一个集总的膨胀系数,低估了 EBR-II 型反馈 | 膨胀反馈的建模方式 |
| 液态燃料临界堆全部出局 | 可能是模型产物 | U-233 的 β_eff 只有 176 pcm,加上静态过冷阶跃判据 | 应改用斜坡式瞬态来判断 |
| 快-热分区谱在聚变方案中占优 | 可能是模型产物 | 两区采用算术平均 | 需要 L2 计算校准 |
9.1 对评价方法本身的评价
第一,闭环确实起了作用。L1 验证发现的漏洞被转化成两道新闸门和一项模型修正,第二轮验证又发现了下一个漏洞,即瞬发跳跃的放大效应。这说明,迭代的价值不在于让超体积一路上升,而在于逐步加强约束集,让”安全”的定义越来越严密。
第二,L0 层级的排序不能脱离模型缺项单独解读。表中三条”可能是模型产物”的结论,原因都是模型遗漏或简化了某项反馈。L0 层级适合用来排除明显不可行的组合,以及找出方案之间的结构性取舍;它不适合用来在相近的方案之间做最终裁决。
第三,价值判断对前沿的形状影响最大。后三个目标的定义,以及聚变功率下限,都属于 [H] 类参数。改变这些参数会显著改变帕累托前沿的形状,但不会改变哪些方案可行,因为可行性由硬门槛决定。这正是”门槛与目标分离”这一设计原则的作用:把价值分歧限制在可行域之内。
十、方法局限、有效性边界与后续工作
本研究的有效性边界是:它能可靠地区分”量级上可行”与”量级上不可行”,并揭示方案之间的结构性取舍;它不能给出任何精确到百分之十以内的物理量,也不能替代任何层级的安全分析。
10.1 已知局限
| 局限 | 可能造成的影响 | 偏差方向 |
|---|---|---|
| 单群截面,精度 ±10% 到 30% | k∞ 与富集度的绝对值有误差 | 不确定 |
| 快-热分区谱采用算术平均 | 分区谱方案可能被高估 | 偏乐观 |
| 静态阶跃的反应性判据 | 液态燃料堆和过冷工况被过度惩罚 | 偏保守 |
| 集总的膨胀反馈 | 金属燃料快堆被低估 | 偏保守 |
| 绝热温升假设 | 瞬态温升偏高 | 偏保守 |
| 集总衰变热模型,无空间分布 | 局部热点被忽略 | 偏乐观 |
| 容器尺寸按固定倍数缩放 | 细长型设计(如 HTR-PM)的被动排热能力被低估 | 偏保守 |
| 不建模燃耗过程 | 平衡态与初装态之间的差异被忽略 | 不确定 |
| 目标函数属于启发式 | 帕累托前沿的形状依赖价值判断 | 不适用 |
10.2 后续工作
按照”先检验结论对哪些假设敏感,再投入更高保真度的计算”的原则排序:
- 新增 β 裕度闸门,例如可引入反应性不超过 0.8 β,或者直接限制瞬发跳跃倍数,用来堵住第二轮发现的漏洞。
- 用等离子体标度模型代替聚变功率下限这个启发式参数,例如建立聚变功率、Q 值与装置尺寸之间的关系,消除目前最大的单一不确定性来源。
- 对液态燃料堆改用斜坡式过冷瞬态,判断它们出局究竟是物理事实还是判据过严。
- 对代表点做 L2 蒙特卡罗计算,用 OpenMC 或 Serpent 校准 k∞、β_eff 和空泡反应性,优先计算 TRISO 球床堆、ADS 熔盐快谱堆和分区谱方案。这一步需要在本地安装核数据库。
- 按可行域宽窄自适应地分配抽样预算,修正 8.4 节发现的搜索深度偏差。
- 把群堆共生纳入评价:在系统层级比较”临界发电堆群 + ADS 焚烧层”组合与单堆方案,这是第二轮分析中判断综合风险最低的体系架构。
10.3 可复现性
全部代码和结果都已交付,计算依赖 Python 3、numpy、scipy 和 matplotlib。全部随机种子都已固定:抽样用 42,第 r 轮优化用 100 + r,稳健性分析用 2026。第一轮和第二轮的运行命令分别是 python3 run.py --out results_v1 和 python3 run.py --learned --out results_v2。